
Aspose.OCR for .NET Site OEM
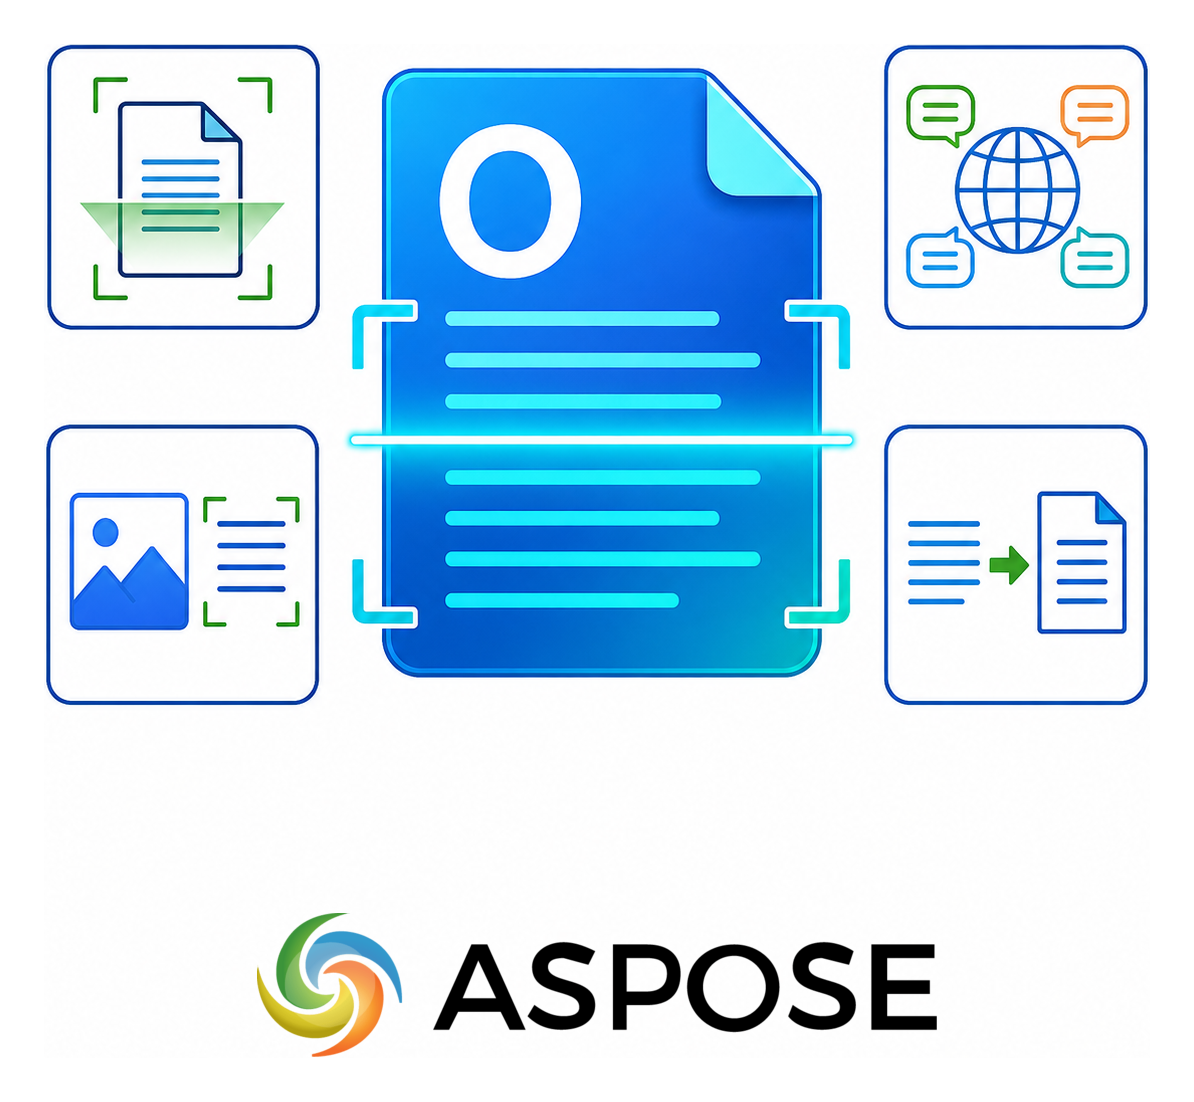
Aspose.OCR for .NET Site OEM - программная библиотека для оптического распознавания символов и извлечения текста из изображений и отсканированных документов. Она позволяет встроить OCR-функции в коммерческие программные продукты, серверные системы, веб-приложения и облачные сервисы на платформе .NET.
С помощью Aspose.OCR команда разработчиков может распознавать текст на фотографиях, сканах, многостраничных TIFF-файлах и PDF-документах, автоматически корректировать наклон и качество исходного изображения, получать координаты найденных слов и сохранять результат в редактируемом или поисковом формате.
Для распознавания не требуется устанавливать сторонние OCR-программы. Обработка может выполняться локально или в инфраструктуре организации без передачи документов во внешние онлайн-сервисы.
Лицензия Site OEM предназначена для компаний, которые разрабатывают коммерческие, тиражируемые или облачные программные продукты. Использовать API могут до 10 разработчиков, а готовые приложения разрешается развертывать в неограниченном количестве мест и распространять среди сторонних заказчиков.
Командная разработка приложений .NET
Aspose.OCR for .NET Site OEM позволяет предоставить доступ к библиотеке команде специалистов. Разработчики могут совместно создавать системы распознавания документов, электронные архивы, сервисы ввода данных и инструменты обработки изображений.
Лицензия подходит организациям, в которых над продуктом работают разработчики серверной и клиентской частей, специалисты по интеграции, тестированию и сопровождению.
Библиотеку можно использовать в приложениях на C#, VB.NET и других языках, поддерживающих платформу .NET.
Распознавание текста на изображениях
Aspose.OCR позволяет извлекать печатный текст из графических файлов. Приложение получает изображение, выполняет распознавание и возвращает текстовые данные.
Поддерживаются распространенные форматы изображений, включая JPEG, PNG, BMP, TIFF и GIF.
Функция подходит для обработки фотографий документов, скриншотов, отсканированных страниц, анкет, справок и других материалов.
Распознавание PDF-документов
Библиотека позволяет обрабатывать отсканированные PDF-файлы, страницы которых содержат изображения вместо доступного для поиска текста.
Aspose.OCR извлекает содержимое страниц и преобразует его в текстовые или поисковые документы.
Эта возможность подходит для оцифровки архивов, договоров, инструкций, отчетов и другой документации.
Создание PDF с текстовым слоем
Aspose.OCR позволяет создавать PDF-документы с распознанным текстовым слоем. Внешний вид исходных страниц сохраняется, но содержимое становится доступным для поиска и копирования.
Такие файлы можно индексировать, хранить в электронном архиве и обрабатывать средствами корпоративных систем.
Поисковые PDF упрощают работу с большими коллекциями отсканированных документов.
Работа с многостраничными TIFF
Библиотека поддерживает распознавание многостраничных TIFF-файлов. Каждая страница может обрабатываться отдельно или как часть общего документа.
Разработчик может извлекать текст из всех страниц и сохранять результат в одном или нескольких выходных файлах.
Многостраничный TIFF часто используется в электронных архивах, системах сканирования и корпоративном документообороте.
Распознавание фотографий документов
Aspose.OCR можно использовать для обработки фотографий, сделанных камерой или мобильным устройством.
Библиотека предоставляет средства предварительной обработки, позволяющие уменьшить влияние наклона, искажений, шума и неравномерного освещения.
Эти возможности подходят для мобильных приложений, удаленного сбора документов и сервисов автоматического ввода информации.
Поддержка разных языков
Aspose.OCR поддерживает распознавание текста на разных языках и письменностях. Разработчик может указывать язык или набор языков, ожидаемых в документе.
Поддержка многоязычного содержимого позволяет обрабатывать международные документы, инструкции, договоры и переписку.
Правильный выбор языка помогает повысить точность распознавания и уменьшить количество ошибочных символов.
Распознавание кириллицы и латиницы
Библиотека подходит для обработки документов с кириллическим и латинским текстом. Она может использоваться для распознавания русскоязычных документов и материалов на европейских языках.
Приложение может обрабатывать документы, в которых встречаются буквы, цифры, знаки препинания и специальные символы.
Aspose.OCR подходит для оцифровки договоров, счетов, актов, анкет и деловой документации.
Распознавание смешанного текста
В одном документе могут одновременно присутствовать текст на разных языках, цифры, даты, номера и специальные обозначения.
Aspose.OCR позволяет настроить распознавание с учетом ожидаемого содержимого.
Эта функция полезна для счетов, технической документации, товарных документов и международных форм.
Распознавание рукописного текста
Для поддерживаемых языков и сценариев Aspose.OCR предоставляет возможности распознавания отдельных вариантов рукописного текста.
Результат зависит от разборчивости почерка, качества изображения, языка и структуры исходного документа.
Функцию можно применять для обработки заполненных вручную форм и других материалов с рукописными данными после предварительного тестирования на типовых документах.
Распознавание таблиц
Aspose.OCR позволяет обнаруживать и распознавать табличные данные на изображениях и сканах.
Полученную информацию можно использовать для восстановления строк и столбцов, последующего анализа и передачи в другие системы.
Эта возможность подходит для счетов, накладных, реестров, ведомостей и других документов со структурированными данными.
Распознавание отдельных областей
Библиотека позволяет ограничивать распознавание выбранной областью изображения. Разработчик может указать координаты участка, содержащего необходимые сведения.
Это ускоряет обработку и помогает исключить элементы, которые не нужно распознавать.
Распознавание областей удобно для типовых форм, анкет, пропусков и документов с фиксированным расположением полей.
Работа с прямоугольными областями
Aspose.OCR позволяет задавать несколько прямоугольных областей для одного изображения. Каждую область можно обработать отдельно.
Приложение может извлекать определенные реквизиты: номер документа, дату, сумму, имя или другой показатель.
Полученные данные можно сразу передавать в поля корпоративной системы.
Определение структуры текста
Библиотека может возвращать не только общий текст, но и информацию о его структуре. Разработчик может получать строки, слова, абзацы и другие доступные элементы.
Структурированные результаты помогают сохранять порядок содержимого и выполнять последующий анализ.
Эта возможность подходит для систем классификации документов и автоматического извлечения данных.
Координаты распознанных элементов
Aspose.OCR позволяет получать координаты обнаруженных слов и областей текста.
Эти данные можно использовать для подсветки результатов, создания интерактивного предварительного просмотра и связывания текста с исходным изображением.
Координаты также помогают реализовать собственную логику анализа структуры документа.
Оценка точности распознавания
Библиотека возвращает информацию, позволяющую оценивать уверенность в распознанном результате.
Приложение может использовать показатель уверенности для автоматической проверки данных и направления сомнительных документов оператору.
Такой подход помогает сочетать автоматическую обработку с ручным контролем сложных случаев.
Автоматическое исправление наклона
Aspose.OCR позволяет определять и исправлять наклон отсканированной страницы.
Выравнивание повышает точность распознавания, особенно если документ был помещен в сканер неровно или сфотографирован под небольшим углом.
После исправления наклона изображение передается алгоритму распознавания.
Поворот изображений
Библиотека может работать с изображениями, повернутыми относительно нормальной ориентации.
Разработчик может программно задавать угол или применять предварительную коррекцию перед распознаванием.
Функция подходит для документов, полученных из разных источников без единого требования к ориентации страниц.
Исправление перспективы
При фотографировании документа под углом его границы и строки могут быть искажены. Aspose.OCR предоставляет средства предварительной обработки, помогающие скорректировать перспективу.
Коррекция улучшает геометрию страницы и повышает точность распознавания.
Эта возможность особенно полезна для мобильных приложений и удаленной загрузки документов.
Удаление шума
Библиотека позволяет уменьшать шум на изображении: случайные точки, мелкие дефекты и следы некачественного сканирования.
Очистка помогает алгоритму лучше отделять символы от фона.
Параметры обработки можно подбирать с учетом качества типовых документов.
Бинаризация
Aspose.OCR поддерживает преобразование изображений в черно-белый вид с отделением текста от фона.
Бинаризация помогает повысить контрастность и улучшить распознавание сканов с неравномерным фоном.
Она может применяться автоматически или как отдельный этап предварительной обработки.
Повышение контрастности
Библиотека позволяет улучшать контраст между текстом и фоном.
Такая обработка полезна для выцветших документов, нечетких копий и фотографий с недостаточным освещением.
После коррекции изображение можно распознать или сохранить для дальнейшего использования.
Изменение размера
Aspose.OCR позволяет увеличивать или уменьшать изображение перед распознаванием.
Увеличение может повысить качество обработки мелкого текста, а уменьшение - сократить ресурсы при работе с избыточно крупными файлами.
Подходящий масштаб выбирается с учетом разрешения и размера символов.
Фильтры предварительной обработки
Библиотека позволяет объединять несколько операций предварительной обработки в последовательность.
Разработчик может настроить выравнивание, удаление шума, коррекцию контрастности, бинаризацию и масштабирование.
Такой подход помогает адаптировать OCR к конкретным типам документов и условиям их получения.
Проверка орфографии
Aspose.OCR предоставляет возможности последующей обработки и проверки распознанного текста.
Словари и языковые параметры помогают исправлять отдельные ошибки, возникающие при распознавании похожих символов.
Проверку можно использовать как дополнительный этап перед сохранением или передачей результата.
Сохранение в текстовые форматы
Результат распознавания можно сохранять как обычный текст для дальнейшего редактирования, поиска и анализа.
Текст можно передать в базу данных, поисковый индекс, систему документооборота или другое приложение.
Такой формат подходит для обработки содержания без необходимости сохранять исходное оформление.
Экспорт в редактируемые документы
Aspose.OCR позволяет сохранять результаты в редактируемые форматы, включая DOCX и другие поддерживаемые типы документов.
Это упрощает дальнейшее редактирование распознанного текста в офисных приложениях.
Экспорт подходит для оцифровки договоров, инструкций, отчетов и архивных материалов.
Экспорт таблиц
Распознанные табличные данные можно сохранять в форматах, подходящих для последующей обработки в электронных таблицах.
Это позволяет переносить сведения из счетов, накладных, реестров и ведомостей в аналитические и учетные системы.
Перед автоматической загрузкой критически важные данные можно дополнительно проверять.
Структурированные результаты
Библиотека позволяет получать результаты в структурированном виде для программной обработки.
Разработчик может использовать JSON, XML или собственные объекты приложения для передачи текста, координат и другой информации.
Структурированный результат упрощает интеграцию OCR с бизнес-логикой и внешними системами.
Пакетное распознавание
Aspose.OCR подходит для автоматической обработки большого количества изображений и документов. Приложение может последовательно загружать файлы, выполнять предварительную обработку и сохранять результаты.
Пакетный режим можно использовать для оцифровки архивов, обработки входящих документов и массового создания поисковых PDF.
Все операции могут выполняться на сервере без участия пользователя.
Обработка папок и потоков данных
Библиотека позволяет получать изображения из файлов, папок и потоков данных.
Работа с потоками удобна для веб-приложений и микросервисов, где документы передаются через сеть или хранятся в базе данных.
Исходный файл можно обработать в памяти без создания временной копии на диске.
Локальная обработка документов
Aspose.OCR можно использовать для распознавания в собственной инфраструктуре организации.
Документы не требуется передавать стороннему облачному сервису, если приложение настроено на локальную обработку.
Это важно для решений, работающих с персональными, финансовыми, медицинскими и другими конфиденциальными данными.
Интеграция с электронными архивами
Библиотеку можно встроить в систему электронного архива для преобразования отсканированных документов в доступный для поиска вид.
Приложение может распознать текст, создать поисковый PDF, извлечь метаданные и передать результат на хранение.
После индексации сотрудники смогут находить документы по их содержимому.
Интеграция с документооборотом
Aspose.OCR можно интегрировать с ECM-, BPM- и другими системами управления документами и бизнес-процессами.
Приложение может получать скан, извлекать текст и реквизиты, классифицировать документ и запускать соответствующий маршрут обработки.
Это помогает сократить ручной ввод данных и ускорить регистрацию входящей документации.
Автоматическая обработка форм
Библиотека подходит для распознавания типовых анкет, заявлений, опросных листов и других форм.
Разработчик может заранее определить области с именем, датой, номером, адресом и другими сведениями.
Полученные значения можно автоматически записывать в базу данных или корпоративную систему.
Обработка счетов и накладных
Aspose.OCR можно использовать как компонент системы извлечения данных из счетов, накладных и других первичных документов.
Библиотека распознает текст и таблицы, после чего приложение определяет необходимые реквизиты по собственным правилам.
Результаты можно передавать в ERP-, учетную или архивную систему.
Обработка удостоверений и анкет
Библиотека подходит для извлечения текста из фотографий удостоверений, пропусков, анкет и других документов.
Приложение может распознавать заранее заданные области и передавать сведения в регистрационную систему.
При обработке персональных данных необходимо учитывать применимые требования к их хранению и защите.
Создание сервисов конвертации
Aspose.OCR можно использовать для разработки сервисов, преобразующих сканы и фотографии в редактируемый текст или поисковый PDF.
Пользователь загружает документ, приложение выполняет распознавание и предоставляет готовый результат.
Такие функции можно включать в корпоративные порталы, коммерческие приложения и SaaS-платформы.
Интеграция с корпоративными системами
Aspose.OCR for .NET можно интегрировать с CRM-, ERP-, ECM-, BPM- и другими информационными системами. Библиотека подходит для автоматического ввода данных, классификации документов и создания электронных архивов.
Приложение может получить изображение, распознать текст, извлечь нужные значения и создать запись в корпоративной системе.
Библиотеку можно использовать в настольных программах, веб-приложениях, серверных службах, микросервисах и облачных решениях на платформе .NET.
Разработка коммерческих продуктов
Лицензия Site OEM подходит для приложений, которые распространяются или предоставляются сторонним пользователям. Компонент Aspose.OCR можно встроить в готовый программный продукт, при этом конечным пользователям не требуется отдельно приобретать лицензию на библиотеку.
Продукт можно использовать для разработки:
- коммерческих приложений на платформе .NET;
- систем распознавания и оцифровки документов;
- электронных архивов;
- облачных сервисов и SaaS-платформ;
- публичных веб-приложений;
- сервисов создания поисковых PDF;
- систем автоматического ввода данных;
- решений для обработки форм и счетов;
- приложений, устанавливаемых в инфраструктуре заказчиков.
Неограниченное количество мест развертывания
Site OEM не ограничивает количество мест, в которых может быть развернуто готовое приложение. Решение можно размещать на серверах разработчика, в облачной инфраструктуре, передавать заказчикам или включать в тиражируемое программное обеспечение.
Это важно для компаний, которые выпускают коробочные продукты, обслуживают множество клиентов или предоставляют распознавание документов через публичные онлайн-сервисы.
При этом использовать API библиотеки в процессе разработки могут до 10 лицензированных разработчиков.
Распространение приложений среди заказчиков
OEM-лицензия разрешает включать функциональность Aspose.OCR в готовые программные продукты для сторонних пользователей. Клиенты работают с возможностями приложения, но не получают библиотеку как самостоятельный инструмент разработки.
Aspose.OCR может использоваться как встроенный компонент коммерческого решения для распознавания, оцифровки и преобразования документов.
Такой вариант лицензирования подходит разработчикам программного обеспечения, системным интеграторам и поставщикам облачных сервисов.
Ключевые возможности
- использование библиотеки командой до 10 разработчиков;
- распознавание текста на сканах и фотографиях;
- обработка PDF и многостраничных TIFF;
- создание PDF с доступным для поиска текстовым слоем;
- поддержка различных языков и письменностей;
- распознавание кириллицы и латиницы;
- обработка таблиц и выбранных областей;
- получение координат слов и оценки уверенности;
- исправление наклона и перспективы;
- удаление шума и повышение контрастности;
- бинаризация и масштабирование изображений;
- экспорт в текстовые, редактируемые и структурированные форматы;
- пакетная и локальная обработка документов;
- интеграция с электронными архивами и системами документооборота;
- распространение готовых приложений среди заказчиков;
- развертывание решений без ограничения количества площадок.
Для кого предназначен продукт
Aspose.OCR for .NET Site OEM подойдет разработчикам программного обеспечения, системным интеграторам и компаниям, которым необходимо:
- предоставить доступ к библиотеке команде специалистов;
- встроить распознавание текста в коммерческий продукт;
- автоматизировать оцифровку документов и архивов;
- создавать PDF с возможностью полнотекстового поиска;
- извлекать данные из форм, счетов и накладных;
- обрабатывать документы в собственной инфраструктуре;
- распространять готовые приложения среди заказчиков;
- создавать облачные сервисы и SaaS-платформы;
- развертывать программные продукты без ограничения количества мест.
Лицензирование
Лицензия Site OEM предназначена для команды до 10 разработчиков и предусматривает неограниченное количество мест развертывания. Она разрешает использовать Aspose.OCR в коммерческих и тиражируемых приложениях на платформе .NET, публичных веб-сервисах, SaaS-платформах и решениях, которые распространяются или предоставляются сторонним пользователям.
Site OEM отличается от Site Small Business возможностью неограниченного развертывания и распространения созданных приложений среди конечных заказчиков.
