
Aspose.OCR for .NET Developer OEM
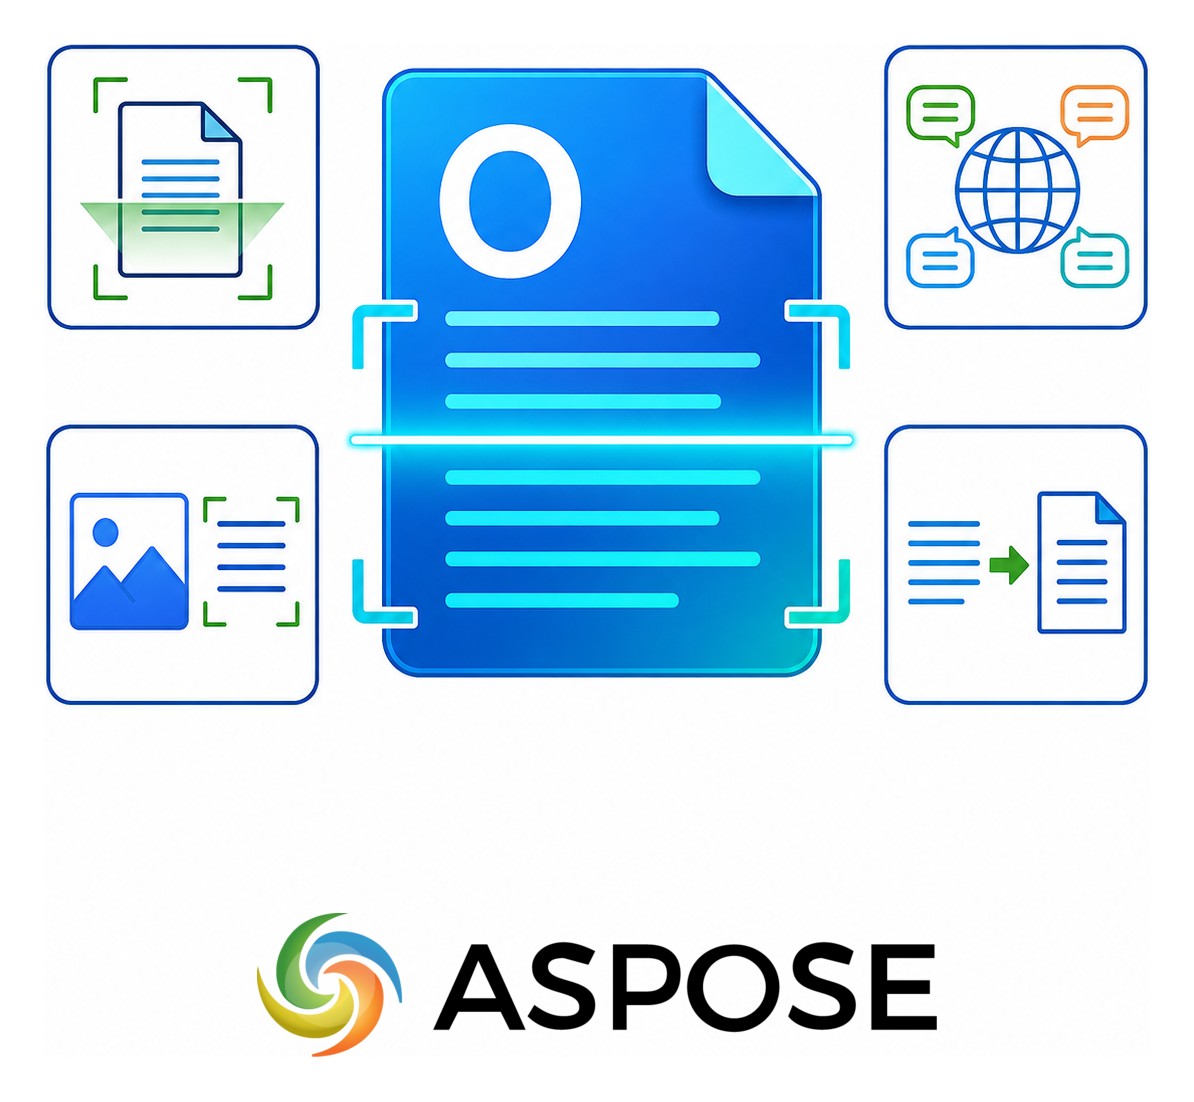
Aspose.OCR for .NET Developer OEM - программный компонент для интеграции оптического распознавания символов в коммерческие, корпоративные и облачные приложения на платформе .NET. Библиотека преобразует изображения и скан-копии документов в текст, который можно редактировать, искать, индексировать и передавать в другие информационные системы.
Решение подходит для SaaS-платформ, систем электронного документооборота, цифровых архивов, сервисов обработки сканов и приложений для автоматического ввода данных. Для распознавания не требуется установка отдельной настольной OCR-программы.
Распознавание текста
Aspose.OCR for .NET позволяет извлекать текст из различных типов изображений и сканированных документов.
Основные возможности:
- распознавание печатного текста;
- обработка одностраничных и многостраничных документов;
- распознавание всего изображения;
- выбор отдельных областей;
- обработка текстовых блоков;
- распознавание таблиц и структурированных данных;
- работа с изображениями низкого качества;
- получение координат распознанных элементов;
- оценка достоверности результата;
- пакетная обработка файлов.
Полученный текст можно использовать для полнотекстового поиска, автоматического заполнения баз данных и создания редактируемых документов.
Поддерживаемые источники
Библиотека может обрабатывать распространенные форматы изображений и документов, включая:
- JPEG;
- PNG;
- TIFF;
- BMP;
- GIF;
- сканированные PDF-документы;
- фотографии;
- снимки экрана;
- многостраничные изображения;
- данные из файлов и потоков.
Набор доступных функций зависит от качества, структуры и формата исходного материала.
Многоязычное распознавание
Aspose.OCR for .NET поддерживает распознавание текста на разных языках и с использованием различных алфавитов.
Компонент можно применять для обработки:
- русскоязычных документов;
- англоязычных материалов;
- европейских языков;
- кириллического и латинского текста;
- документов с несколькими языками;
- отдельных специализированных наборов символов.
Выбор языка распознавания помогает повысить точность обработки документа.
Подготовка изображений
Качество исходного изображения влияет на результат OCR. Библиотека предоставляет средства предварительной обработки, помогающие подготовить скан или фотографию к распознаванию.
Доступны:
- коррекция наклона;
- поворот изображения;
- устранение искажений;
- повышение контрастности;
- удаление шума;
- бинаризация;
- изменение масштаба;
- автоматическое выравнивание;
- выделение областей с текстом;
- обработка фона.
Параметры предварительной обработки можно выбирать с учетом качества исходных файлов.
Распознавание отдельных областей
Aspose.OCR for .NET позволяет обрабатывать не весь документ, а только заданные участки изображения.
Эта функция подходит для извлечения:
- номера документа;
- даты;
- суммы;
- реквизитов;
- контактных данных;
- отдельных таблиц;
- подписей к полям;
- других типовых значений.
Обработка выбранных областей помогает ускорить распознавание и упростить анализ результата.
Таблицы и структурированные документы
Библиотеку можно применять для извлечения информации из документов с табличной или типовой структурой.
Типовые примеры:
- счета;
- накладные;
- акты;
- анкеты;
- заявления;
- реестры;
- прайс-листы;
- отчеты;
- формы с фиксированным расположением полей.
Приложение может распознать текст, получить его координаты и распределить найденные значения по нужным полям.
Обработка PDF
Aspose.OCR for .NET позволяет извлекать текст из отсканированных PDF-документов, страницы которых представлены в виде изображений.
Компонент можно использовать для:
- распознавания отдельных страниц;
- обработки многостраничных файлов;
- извлечения текста;
- создания доступного для поиска документа;
- преобразования сканов в редактируемые форматы;
- подготовки материалов к индексации;
- обработки архивных PDF-файлов.
Это помогает сделать сканированные документы доступными для поиска и дальнейшей автоматической обработки.
Сохранение результатов
Результат распознавания можно передавать в приложение или сохранять в распространенных форматах.
В зависимости от выбранного сценария доступны:
- обычный текст;
- PDF с текстовым слоем;
- DOCX;
- XLSX;
- HTML;
- JSON;
- XML;
- CSV и другие поддерживаемые форматы.
Формат результата можно выбирать с учетом последующего редактирования, поиска, анализа или импорта в корпоративную систему.
Контроль точности
Библиотека предоставляет данные, которые помогают оценить качество распознавания.
Разработчик может:
- получать распознанный текст;
- анализировать показатели достоверности;
- проверять отдельные слова и строки;
- получать координаты элементов;
- отмечать фрагменты с низкой уверенностью;
- направлять сомнительные результаты на ручную проверку;
- сравнивать результат с заданными шаблонами.
Это позволяет построить контролируемый процесс автоматического ввода информации.
Пакетная обработка
Aspose.OCR for .NET подходит для обработки большого количества документов без участия пользователя.
Можно автоматизировать:
- распознавание папок со сканами;
- обработку многостраничных TIFF;
- извлечение текста из PDF;
- создание поисковых копий;
- преобразование изображений в текст;
- сортировку документов;
- передачу результатов в базы данных;
- формирование электронного архива.
Библиотеку можно использовать в серверных службах, облачных системах и фоновых процессах.
Электронные архивы и документооборот
Компонент помогает переводить бумажные и отсканированные документы в цифровой вид.
Типовой процесс может включать:
- загрузку скана;
- предварительную обработку изображения;
- распознавание текста;
- проверку результата;
- присвоение метаданных;
- сохранение поисковой копии;
- передачу данных в систему документооборота;
- индексирование документа.
Такой подход упрощает поиск, классификацию и обработку больших объемов архивной информации.
Интеграция с приложениями .NET
Aspose.OCR for .NET можно применять в:
- настольных приложениях;
- веб-системах;
- серверных службах;
- REST API;
- микросервисах;
- SaaS-платформах;
- системах документооборота;
- электронных архивах;
- сервисах ввода данных;
- тиражируемых коммерческих продуктах.
Компонент позволяет встроить OCR непосредственно в программное решение и связать распознавание с другими бизнес-процессами.
Для кого предназначен продукт
Aspose.OCR for .NET Developer OEM подойдет независимым .NET-разработчикам, производителям коммерческого программного обеспечения, поставщикам SaaS-сервисов, создателям систем документооборота, электронных архивов и сервисов автоматического ввода данных.
Лицензия Developer OEM
Лицензия Developer OEM предназначена для одного разработчика. Она позволяет интегрировать Aspose.OCR for .NET в собственный программный продукт и развертывать готовое решение в неограниченном количестве физических или виртуальных мест.
OEM-вариант подходит для приложений, которые устанавливаются у нескольких заказчиков, распространяются среди конечных пользователей или предоставляются в виде веб-, облачного либо SaaS-сервиса. Пользователи получают доступ к реализованным функциям распознавания текста, но не к Aspose.OCR for .NET как к самостоятельной библиотеке.
Если над продуктом будут работать несколько разработчиков, следует рассмотреть лицензию Site OEM.
